
Data Lake vs Data Warehouse e il ruolo dell'ETL. Vale ancora la pena creare un ETL su misura?
Si parla di Big Data ormai da tempo, eppure per molti resta difficile strutturarli e conservarli nel modo giusto. Vediamo le differenze tra Data Lake e Data Warehouse e che cosa significa ETL.
Data Lake vs Data Warehouse
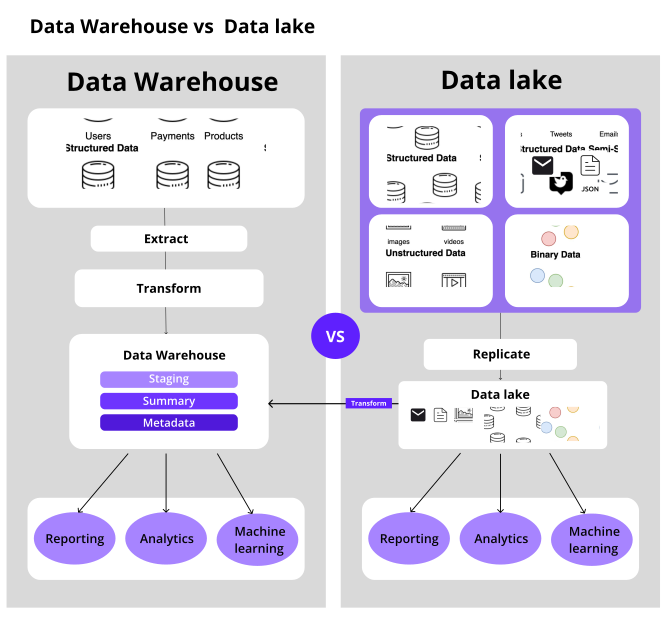
Data Lake e Data Warehouse servono entrambi ad aggregare più fonti di dati, ma hanno scopi e architetture diversi.
Un Data Warehouse (DWH) è un sistema che consolida i dati provenienti da fonti diverse in un unico archivio centralizzato e coerente. Il suo obiettivo principale è supportare l'analisi dei dati, il data mining, l'intelligenza artificiale e il machine learning, accogliendo grandi volumi di dati da tutti i reparti dell'organizzazione. Un Data Lake, invece, propone un approccio alternativo alla conservazione e all'elaborazione di grandi volumi di dati. A differenza del Data Warehouse, dove i dati sono strutturati in anticipo all'interno di un modello relazionale e seguono uno schema definito, un Data Lake offre uno spazio in cui conservare qualsiasi tipo di dato: strutturato (come le tabelle dei database relazionali e i file Excel), semi-strutturato (ad esempio file XML o JSON e pagine web) e non strutturato (immagini, file audio, post sui social). Questo approccio permette di conservare i dati grezzi senza alcuna elaborazione preliminare, lasciando flessibilità per le analisi successive.
Che cos'è l'ETL?
L'ETL (Extract, Transform, Load) è un processo di integrazione dei dati che serve a estrarli da fonti diverse, trasformarli in un formato coerente e infine caricarli in un Data Warehouse per l'analisi e la reportistica.
Le fonti dati di un ETL possono essere molto varie:
Database: SQL Server, Oracle, MySQL, MongoDB. Sistemi CRM: Salesforce, HubSpot. File CSV, Excel, XML. Servizi web: API, web scraping.
Il processo ETL:
- Passo 1 - Estrazione
- Passo 2 - Trasformazione
- Passo 3 - Caricamento
Vediamo il processo ETL con l'esempio di un'azienda del retail:
- Estrazione: si parte dai dati provenienti dai vari sistemi CRM, con le informazioni sui clienti come nome, indirizzo email, data dell'ultimo acquisto e importo speso.
- Trasformazione: in questa fase i dati vengono standardizzati. Per esempio i nomi vengono convertiti in maiuscolo, gli indirizzi email in minuscolo, le date formattate come GG-MM-AAAA e gli importi mostrati con due decimali. Diverse regole di business stabiliscono come trasformare i dati: scartare i record che non rispettano certi criteri, per esempio, oppure unire dati provenienti da fonti diverse.
- Caricamento: infine i dati vengono caricati nel data lake dell'azienda, con aggiornamenti attesi su base quotidiana. Il risultato è che l'azienda dispone di dati puliti e standardizzati, utilizzabili per analizzare gli acquisti e pianificare le campagne di marketing.
Ristoranti e bar possono usare i processi ETL per ottimizzare le consegne, integrando i dati di fonti diverse come il proprio sito e le piattaforme di delivery. Così riescono a gestire i fattorini in modo efficace, a ridurre i tempi di consegna e a migliorare l'esperienza del cliente.
Un approccio alternativo è l'ELT (Extract, Load, Transform), in cui i dati vengono prima estratti, poi caricati in un Data Lake e solo in seguito trasformati nel formato richiesto.
Gli strumenti ETL moderni più diffusi sul mercato
Grazie a questi strumenti puoi monitorare i flussi di lavoro; offrono inoltre integrazione dei dati, controllo della qualità e gestione dei dati anagrafici.
- Airflow
- Airbyte
- DBT
- Prefect
Perché un ETL su misura è indispensabile per le aziende:
Un'azienda può avere bisogno di una soluzione ETL su misura quando:
- ha fonti dati o requisiti di integrazione particolari che gli strumenti ETL preconfezionati non riescono a coprire.
- vuole il controllo completo del processo ETL, dalla qualità dei dati alla logica di trasformazione fino alla gestione degli errori.
- ha requisiti stringenti di sicurezza e conformità che gli strumenti ETL in cloud non possono soddisfare.
- deve ampliare o personalizzare pipeline ETL già esistenti.
Vale ancora la pena creare un ETL su misura
Assolutamente sì. Con i nostri servizi ETL aiutiamo i clienti non solo a integrare i dati provenienti da fonti diverse, ma anche a garantirne l'elevata qualità, un aspetto decisivo per prendere decisioni di business consapevoli. Vista la varietà delle fonti e dei requisiti di elaborazione, l'ETL resta uno strumento fondamentale nell'arsenale di un'azienda per raggiungere l'efficienza analitica e sostenere le iniziative strategiche.
Ti serve aiuto per costruire un data warehouse? Affidati all'esperienza di CODECAVE
CODECAVE è un fornitore di servizi IT con competenze tecniche molto ampie: big data analytics, data science, IA e ML, soluzioni cloud, sviluppo di plugin su misura per Autodesk AutoCAD® e Revit®, visualizzazione 3D interattiva, esperienze AR e VR capaci di coinvolgere gli utenti, DevOps e molto altro. Il nostro team di sviluppo software crea soluzioni per aziende del fintech, del retail, dell'industria alimentare, dei media, dell'automotive, della sanità e di altri settori. Aiutiamo molti clienti a sfruttare i loro warehouse e data lake, a gestire i Big Data, a migliorare la business intelligence e a ricavarne il massimo valore.
Per esempio, nell'ambito della collaborazione con un'azienda italiana della ristorazione (coperta da NDA), il team di CODECAVE ha realizzato il sistema di data warehouse per conservare ed elaborare volumi di dati considerevoli. Il team ha implementato un sistema di categorizzazione dei dati basato sul machine learning, che ha permesso di caricarli nel warehouse sezione per sezione. Il sistema consente all'azienda di ricevere report tempestivi e costituisce la base dei processi operativi.
Se hai domande sul processo ETL o sul valore che può avere per la tua azienda, contatta il nostro team per una consulenza gratuita.